近日,由团队常晋源教授与杨麟博士后、普渡大学张贻辰副教授以及伊利诺伊大学芝加哥分校周文心副教授合作完成的论文“Feature-Rich, Data-Private: A Sparse Learning Framework for the High-Dimensional Newsvendor”被管理科学与运筹学国际顶级学术期刊《Operations Research》正式接收。
内容简介
当库存决策进入高维数据时代
高维特征广泛存在于现代零售和供应链管理中。企业可以从历史销量、宏观经济指标,以及文本、图像和网络数据中提取大量信息,用于辅助库存决策。但当候选特征数量很大时,模型容易受到无关变量影响;与此同时,这些高维经营数据以及由其产生的订货决策还可能泄露敏感需求信息。针对这一问题,本文聚焦高维特征报童问题中的稀疏学习与隐私保护,基于最优订货决策仅由少数关键特征驱动这一稀疏结构,提出差分隐私稀疏经验风险最小化方法,在充分利用丰富特征信息的同时,缓解高维度和隐私噪声对库存决策的影响。
用稀疏结构应对高维下的隐私保护难题
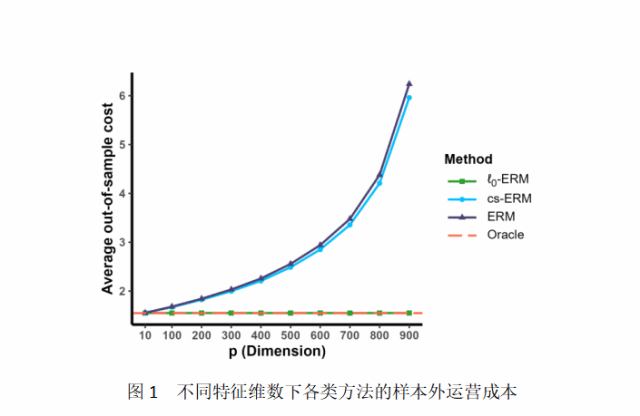
本研究将卷积平滑与带噪声的迭代硬阈值方法相结合。卷积平滑用于处理报童损失函数的非光滑性,硬阈值操作则使参数在迭代过程中保持稀疏,从而使隐私保护所需加入的噪声主要依赖于稀疏度 s,而不是完整特征维数 p。论文进一步建立了订货决策误差和额外运营成本的非渐近理论结果,刻画了隐私强度、稀疏度、样本量和特征维数之间的关系。理论结果表明,当真正影响需求的特征数量较少时,即使候选特征维数很高,仍可以保持良好的库存决策性能。如图1所示,随着候选特征维数增加,稀疏方法的样本外运营成本保持相对稳定,而非稀疏方法的表现明显下降。
在隐私保护与库存决策表现之间取得平衡
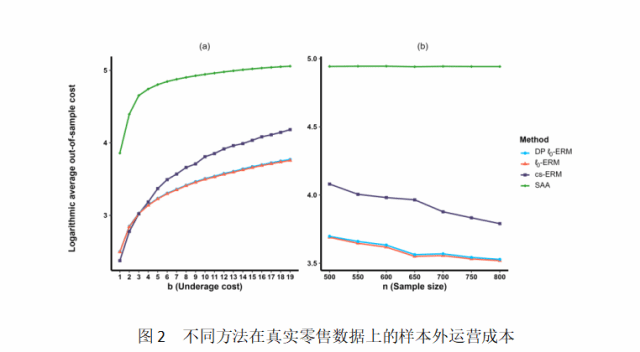
研究还通过模拟和真实零售数据分析考察了所提方法的有限样本表现。数据分析结果表明,所提方法在保护数据隐私的同时,仍保持了接近非隐私方法的库存决策表现,并优于不利用特征信息或未考虑稀疏结构的对比方法。如图2所示,所提方法在不同目标服务水平下均保持了接近非隐私方法的表现,并在不同样本量下展现出较好的稳定性。
此外,研究从管理角度讨论了隐私保护的作用。对企业而言,加强数据隐私保护不仅有助于降低敏感信息泄露风险,还可能增强对隐私敏感消费者的吸引力,并改变上游供应商从企业订单中获取的需求信息。本文将稀疏学习与差分隐私结合,为企业在高维、数据丰富且具有隐私要求的环境下开展库存决策提供了新的方法,并为理解运营效率与数据安全之间的权衡提供了理论依据。
作者简介
常晋源,西南财经大学光华首席教授、统计交叉创新研究院执行院长、数据科学与商业智能联合实验室执行主任。主要从事大规模复杂数据分析相关的研究。
杨麟,西南财经大学数据科学与商业智能联合实验室博士后。主要从事高维数据分析和函数型数据分析等领域的研究。
张贻辰,普渡大学副教授。主要从事随机系统中的在线推断、异质数据下的分布式推断,以及复杂运营系统中的数据驱动优化等领域的研究。
周文心,伊利诺伊大学芝加哥分校副教授。主要从事高维统计与稳健推断、非参数学习与现代机器学习方法、深度学习与神经网络理论,以及分位数回归与期望短缺回归等领域的研究。
电话:86-028-87352207
地址:四川省成都市青羊区光华村街55号
邮编:610074
西南财经大学 数据科学与商业智能联合实验室 版权所有
蜀ICP备05006386号